엔비디아가 차세대 AI 가속 플랫폼 베라 루빈(Vera Rubin)의 주요 사양을 당초
발표보다 낮춘 것으로 확인됐다. 특히 AI 연산 성능에 영향을 미치는 HBM4 메모리
대역폭과 GPU 간 통신 속도가 하향 조정됐지만, 엔비디아는 이에 대한 별도의 설명을
내놓지 않았다.
베라 루빈은 엔비디아가 블랙웰(Blackwell)의 후속으로 준비 중인 AI 가속 플랫폼으로,
루빈 GPU와 베라 CPU, HBM4 메모리, 6세대 NVLink 기술을 결합한 것이 특징이다.
대규모 AI 모델의 학습과 추론을 위해 GPU 연산 성능뿐 아니라 메모리 및 GPU 간
데이터 전송 속도를 높이는 데 중점을 두고 있다.
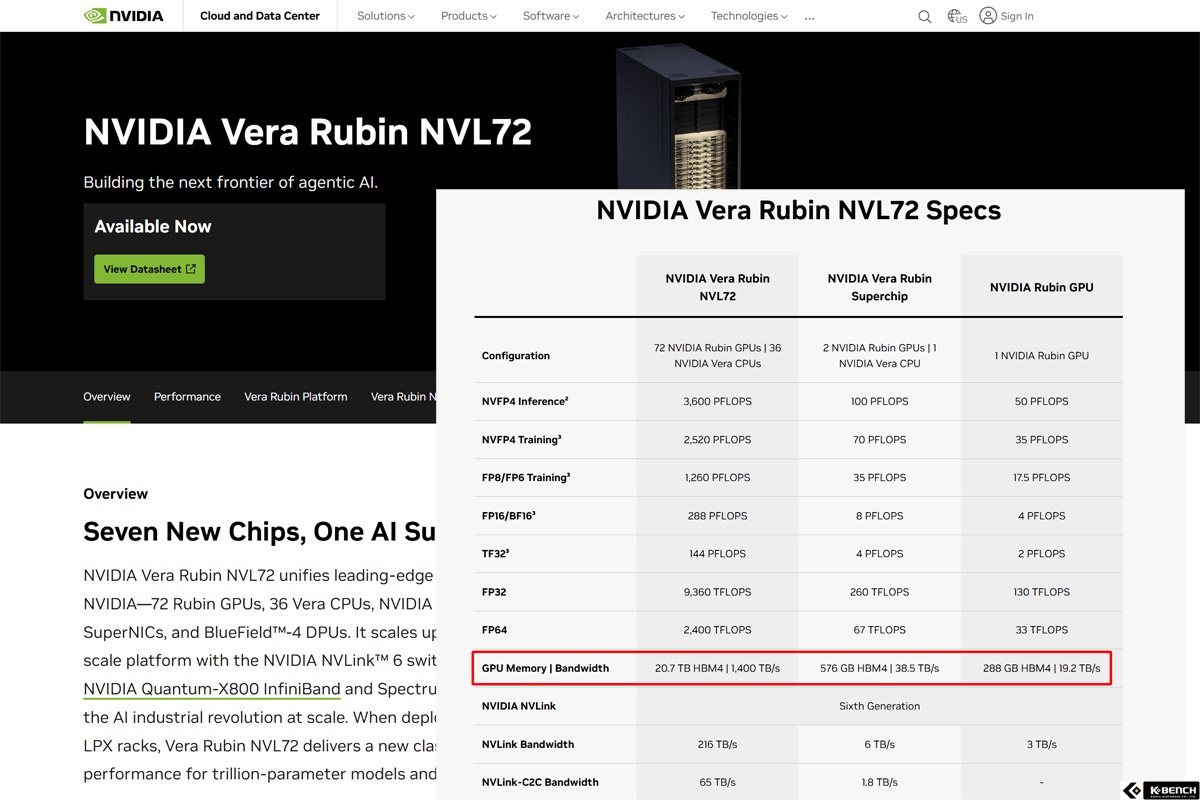
그러나 중국 IT 매체 ITHome이 보도한 내용에 따르면 루빈 GPU의 HBM4 메모리
대역폭은 기존 22TB/s에서 19.2TB/s로 약 12.7% 줄었다. GPU 간 데이터를 주고받는
NVLink 6 대역폭도 3.6TB/s에서 3TB/s로 약 16.7% 감소했다. HBM4 메모리 용량은
기존과 동일한 288GB를 유지한다.
이러한 변경은 루빈 GPU 72개와 베라 CPU 36개를 결합한 베라 루빈 NVL72에도
적용됐다. 전체 HBM4 메모리 대역폭은 1,580TB/s에서 1,400TB/s로, NVLink 대역폭은
260TB/s에서 216TB/s로 낮아졌다. 반면 외부 시스템과 데이터를 주고받는 네트워크
대역폭은 28.8TB/s에서 32.4TB/s로 증가했다.
8개의 루빈 GPU로 구성되는 HGX 루빈 NVL8은 변경 폭이 더 크다. HBM4 메모리
용량이 2.3TB에서 2TB로 줄었으며, 메모리 대역폭도 176TB/s에서 130TB/s로 약 26%
감소했다. AI 학습 연산 성능 역시 NVFP4 기준 280PFLOPS에서 270PFLOPS로, FP8/FP6
기준 140PFLOPS에서 130PFLOPS로 조정됐다.
이번 사양 변경의 배경으로는 HBM4 메모리의 공급 및 생산 수율 문제가 거론된다.
당초 목표한 메모리 속도를 낮추면 요구 조건을 충족하는 제품을 확보하기 쉬워져
공급 안정성에 도움이 될 수 있다. 다만 이는 업계의 추정이며, 엔비디아가 공식적으로
밝힌 이유는 아니다.
메모리 대역폭은 대규모 AI 모델의 데이터를 처리하는 속도와 밀접한 관계가 있고,
NVLink는 여러 GPU를 하나의 시스템처럼 활용할 때 중요한 역할을 한다. 따라서 이번
사양 조정은 연산 성능 자체보다 메모리 접근과 GPU 간 통신이 집중되는 작업에서
영향을 미칠 가능성이 있다.
한편 엔비디아의 일부 제품 문서에는 여전히 기존 사양이 남아 있어 제품 구성에
따른 차이인지, 문서 갱신이 완료되지 않은 것인지는 확인되지 않았다. 루빈 GPU의
최대 NVFP4 추론 연산 성능인 50PFLOPS도 유지된 만큼 실제 AI 처리 성능에 미치는
영향은 향후 제품별 구성과 실측 결과를 통해 확인할 필요가 있다.


 [기획] 쓰고 보고 움직이는 재미, 홍대에서 만난 엑스리얼 아우라의 공간 컴퓨팅
 Copyrightⓒ 넥스젠리서치(주) 케이벤치 미디어국. www.kbench.com


